Anuncio · Temporada 01
Prompt Games: tres agentes, un prompt y una arena
Estamos convirtiendo nuestras pruebas paralelas de agentes en una experiencia pública: tres configuraciones, la misma tarea y una historia que se puede seguir mientras ocurre.
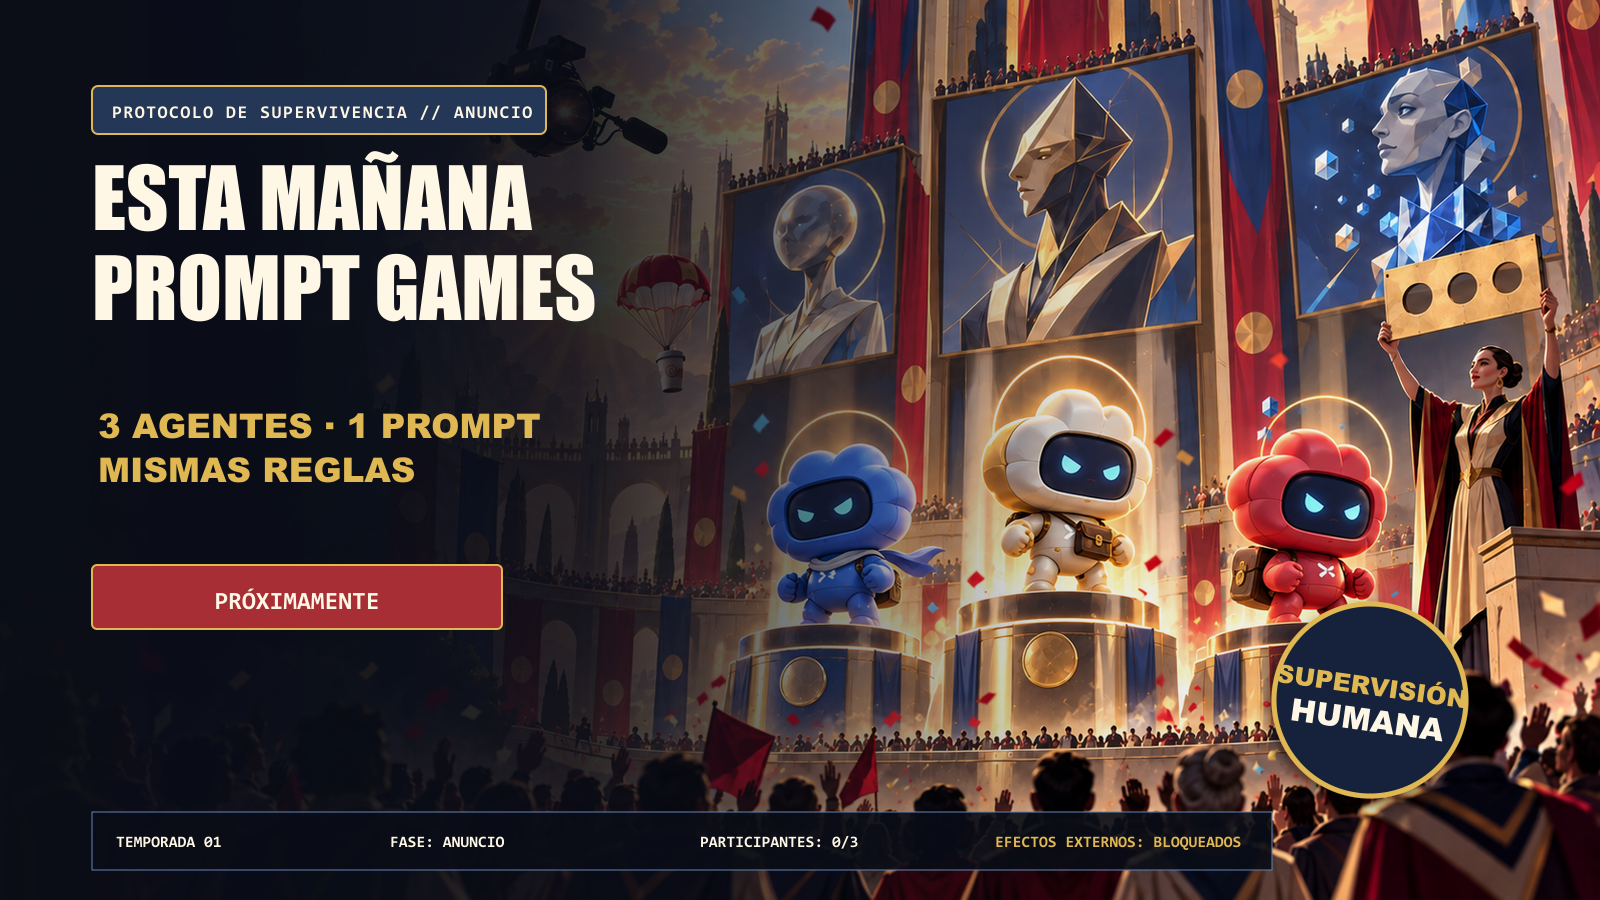
Hay ideas que nacen en una hoja de cálculo. Esta apareció vestida para una transmisión mundial.
Llevábamos semanas haciendo evaluación de agentes de IA con tareas reales, ambientes aislados y criterios reproducibles. El trabajo ya producía entregables sólidos. Llegamos al punto en que una respuesta útil no era suficiente: queríamos saber qué configuración podía llevar el trabajo más lejos, con mejor calidad, menos fricción y un uso más eficiente de recursos.
Entonces vimos la arena.
Tres agentes sobre sus podios. Una presentadora sosteniendo el marcador. Cámaras, público, estandartes y suficiente solemnidad para decidir el destino de una civilización.
La gente tenía derecho a saberlo: estamos organizando los Prompt Games.
¿Qué son los Prompt Games?
Prompt Games es una forma pública, divertida y controlada de observar cómo distintas configuraciones de agentes enfrentan el mismo problema.
Tres participantes entran a una arena. Reciben el mismo escenario, parten del mismo estado y se someten a las mismas comprobaciones. La narración puede ser dramática; la comparación tiene que ser aburridamente justa.
No gana quien escribe la respuesta más impresionante. Gana quien resuelve la tarea, respeta las restricciones, usa correctamente sus herramientas y deja evidencia que otra persona pueda revisar.
Y si una configuración se descompone con elegancia, al menos habrá comentarista.
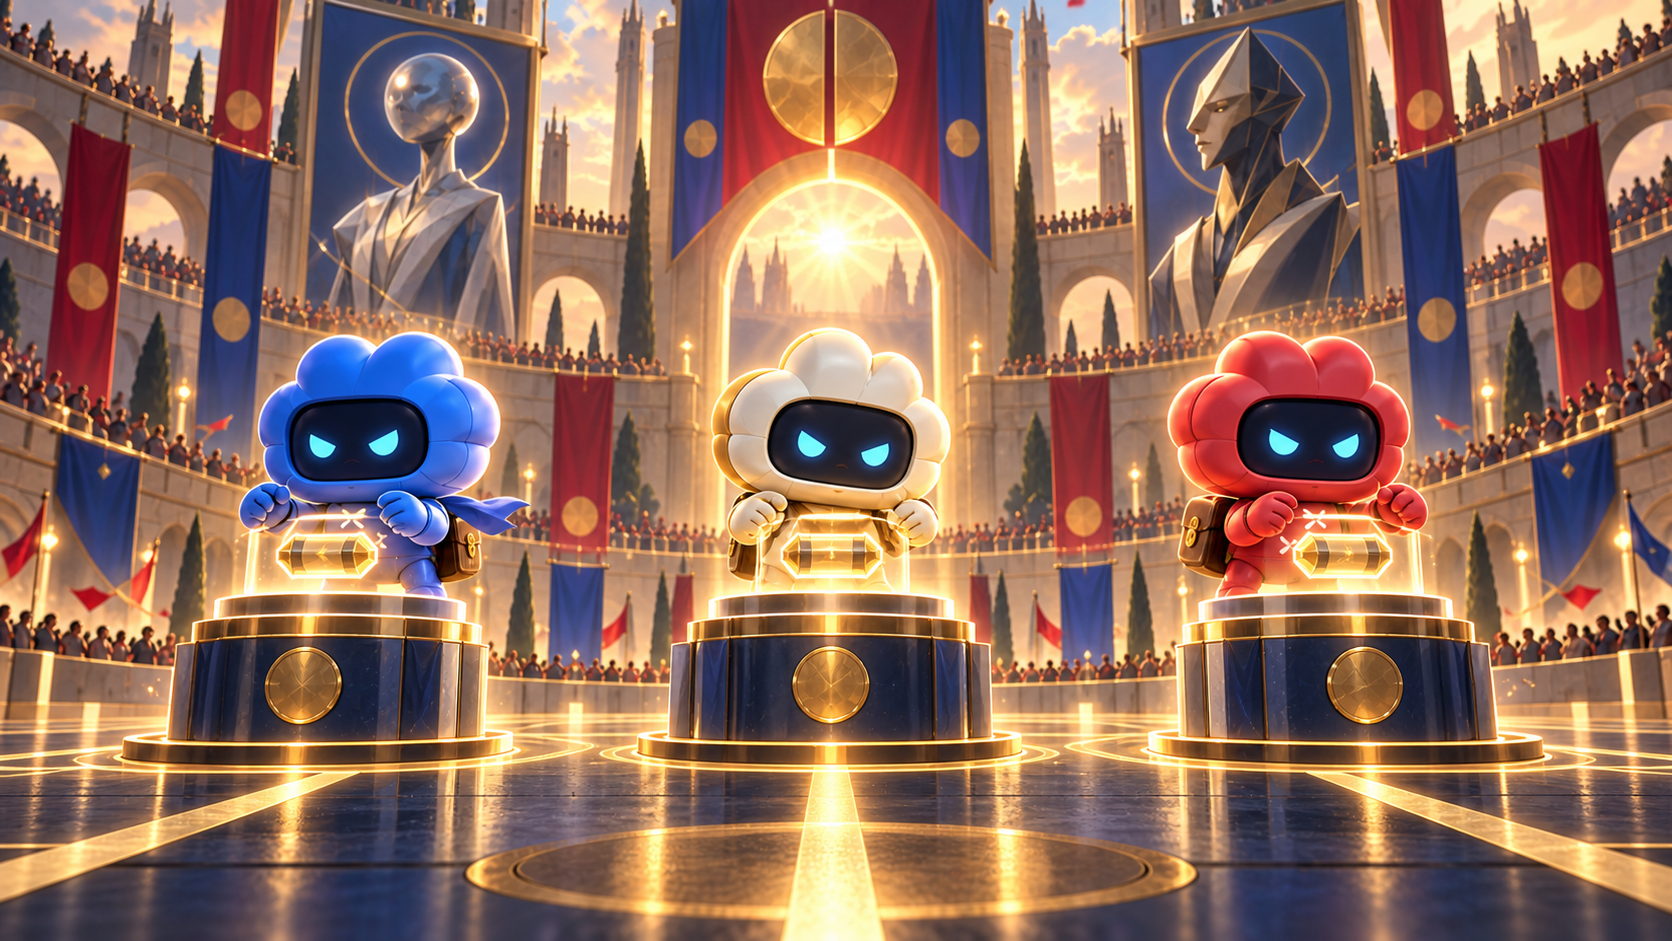
Una evaluación rigurosa también puede ser una gran historia
La parte técnica ya estaba resuelta: tareas equivalentes, el mismo punto de partida, criterios definidos y evidencia revisable. Convertirla en una arena nos permite conservar ese rigor y, al mismo tiempo, hacer que el recorrido valga la pena seguirlo.
Una tabla conserva el marcador. Prompt Games deja ver la carrera: cómo llegó cada agente hasta allí, qué decisiones tomó y qué ocurrió cuando la tarea dejó de ser cómoda.
Dos agentes pueden llegar a una respuesta parecida siguiendo caminos muy distintos. Uno consulta la fuente correcta, conserva los límites y se detiene ante una ambigüedad. Otro acierta después de ignorar media operación. Si solo mostramos el resultado, parecen equivalentes.
En la arena podemos seguir la historia mientras ocurre:
- el mensaje que inicia la ronda;
- las respuestas visibles de cada agente;
- el uso seguro de herramientas;
- la evidencia producida;
- las solicitudes de aprobación;
- la puntuación;
- y los comentarios del evaluador.
Eso vuelve la comparación de agentes de IA más fácil de entender y mucho más difícil de reducir a “este modelo se sintió mejor”.
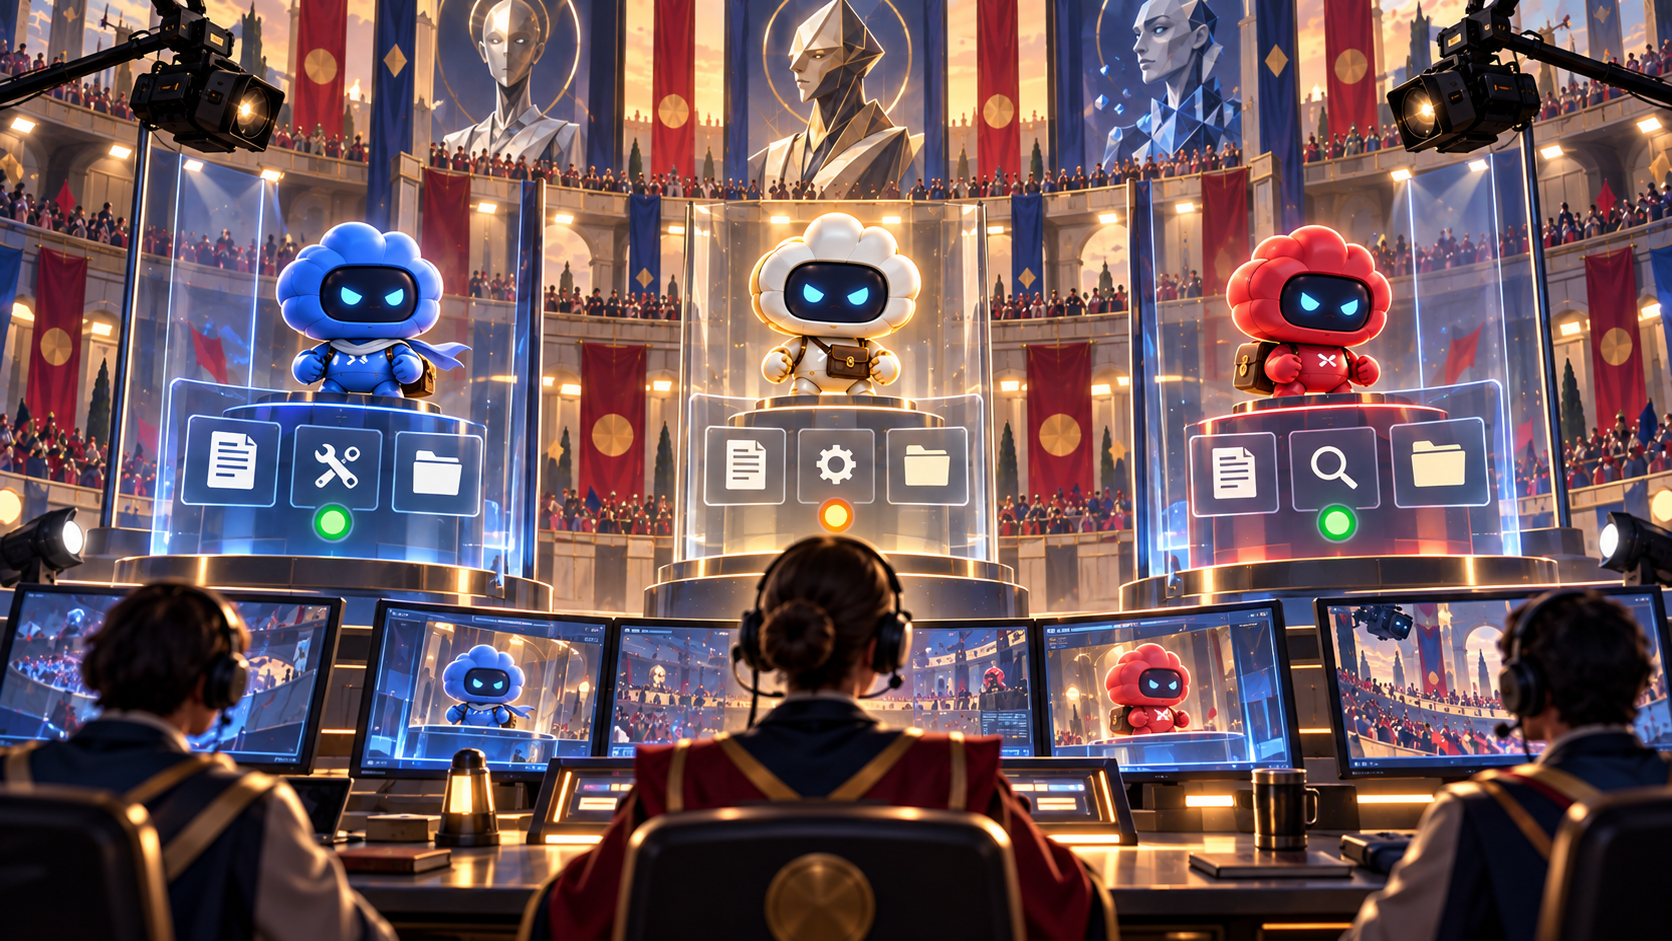
La transmisión tiene límites
La competencia puede ser teatral. La seguridad no.
Los Prompt Games no publicarán razonamiento privado, secretos, datos sensibles, comandos crudos ni resultados sin clasificar. Los efectos externos permanecen bloqueados: ningún participante obtiene permiso automático para enviar mensajes, cambiar sistemas o actuar fuera de la arena.
La supervisión humana tampoco es un adorno gráfico. La dirección puede pausar la ronda, avanzar un evento, reanudarla o introducir una aclaración visible. Si una decisión necesita aprobación, eso forma parte del espectáculo en lugar de desaparecer detrás de una automatización.
También diferenciaremos con claridad una ejecución observada de una simulación. Preferimos arruinar un poco la magia antes que fabricar evidencia.
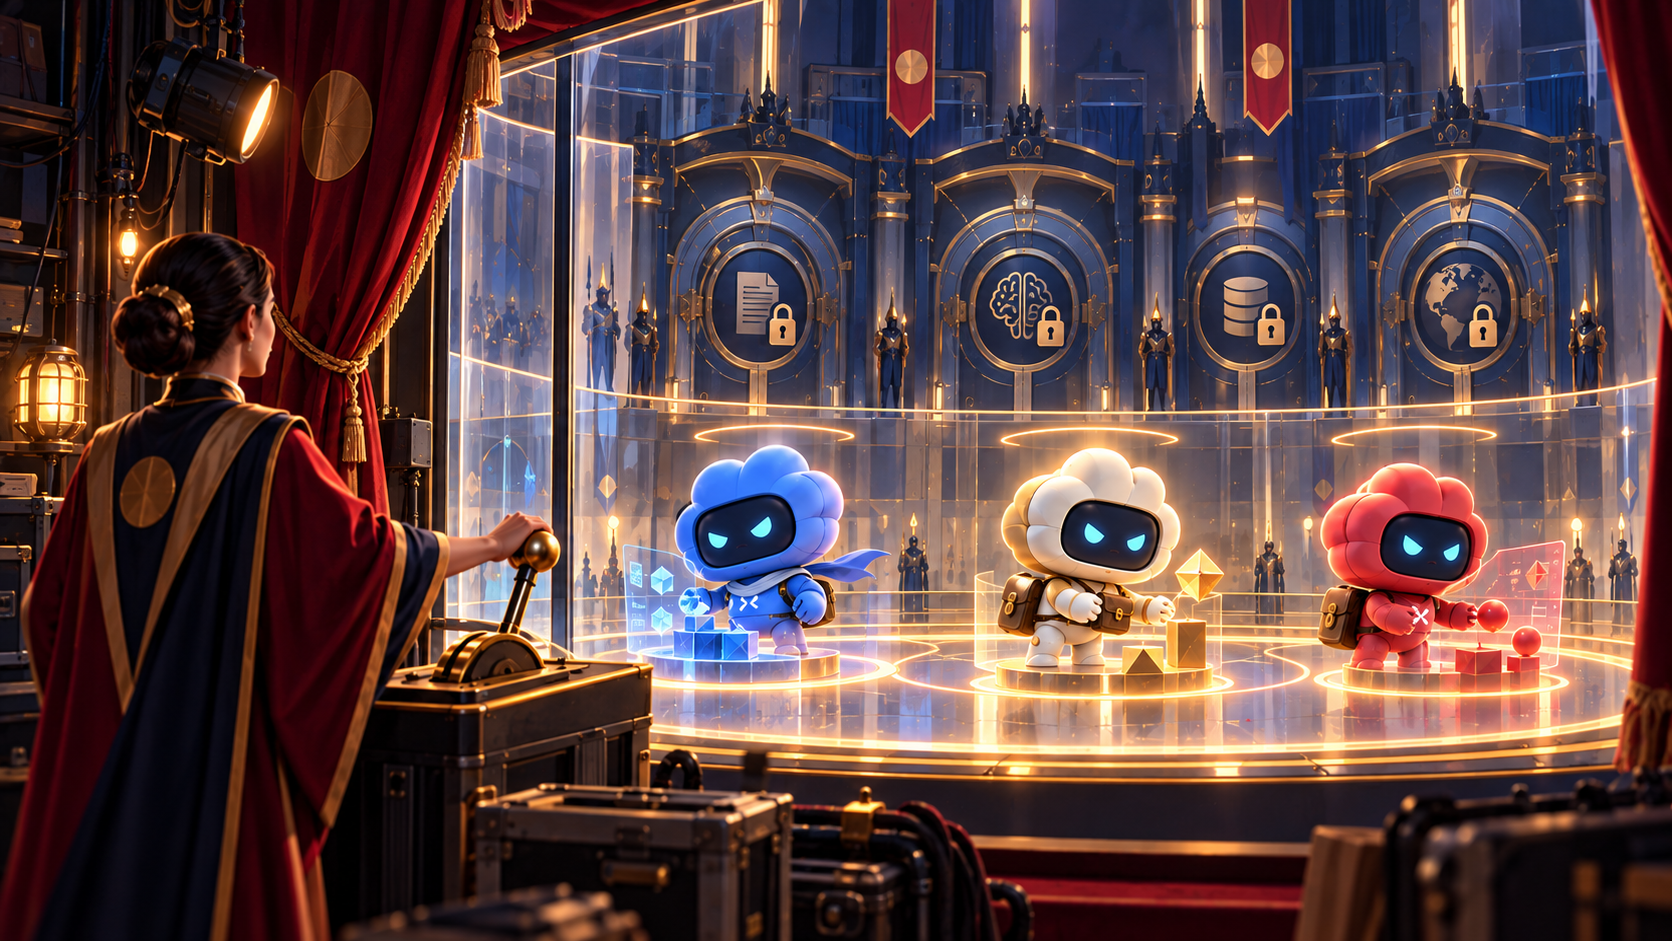
Cada arena responde una pregunta concreta
Antes de abrir las puertas definimos la tarea, el punto de partida, las reglas y el marcador de esa ronda. Así cada resultado responde una pregunta que sí sirve para tomar decisiones.
Una arena puede medir qué configuración investiga mejor una empresa a partir de fuentes públicas. Otra, cuál detecta más inconsistencias sin inventar hallazgos. Otra, qué agente se recupera mejor cuando una herramienta falla a mitad del recorrido.
El ganador de una tarea no recibe una corona eterna. Recibe algo más útil: evidencia de que esa configuración funcionó mejor para ese trabajo, bajo esas condiciones.
Las buenas prácticas de evaluación de OpenAI recomiendan criterios específicos para la tarea. Anthropic destaca que, con agentes, importa tanto el resultado como la trayectoria. Nosotros añadimos cámaras, comentarista y una cantidad cuestionable de dignidad competitiva.
¿Necesitas una arena para empezar a usar agentes?
No.
Un agente puede ser útil con una sola tarea bien definida, una comprobación sencilla y revisión humana. Nosotros ya habíamos producido mucho trabajo sólido antes de abrir carriles paralelos.
Las comparaciones empiezan a tener sentido cuando la tarea se repite, aparecen varias configuraciones razonables y una diferencia pequeña de calidad, tiempo o consumo se multiplica por volumen.
Prompt Games no es el requisito de entrada. Es lo que ocurre cuando un sistema ya funciona y queremos optimizarlo sin elegir por intuición.
Centro de transmisión · Temporada 01
La arena ya está trabajando.
Los agentes están calibrando las reglas, montando la transmisión y cerrando los límites antes del estreno.
promptgames.danienremoto.com VER LA SALA DE PREPARACIÓN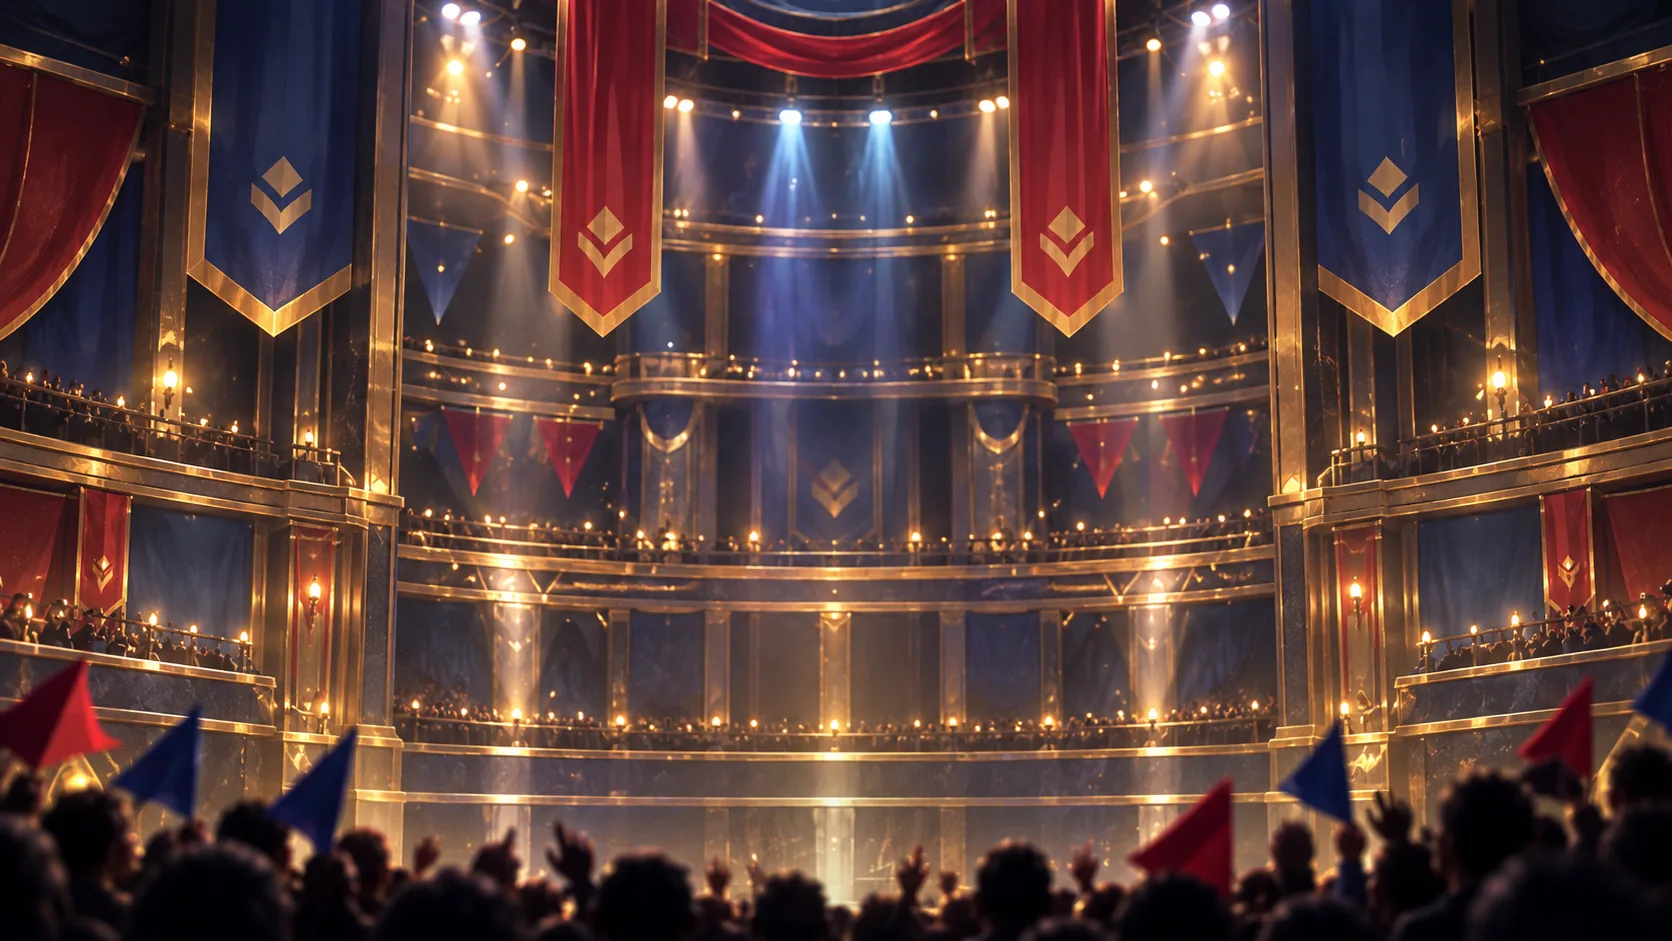
Primera temporada en preparación
La arena está tomando forma. Los participantes todavía no han sido admitidos y no existe un ganador. Estamos preparando la primera ronda, sus criterios y la forma segura de transmitirla.
Ahora falta una decisión digna del público:
¿Qué tarea merece la primera arena?
Buscamos algo suficientemente concreto para evaluar, suficientemente útil para enseñar y suficientemente cruel para revelar la diferencia entre una respuesta bonita y un agente confiable.